TD1: Programmation dynamique
En cours, nous avons découvert les processus de décision Markoviens (MDP) et des algorithmes pour les résoudre.
Représentations
MDP
Téléchargez l'archive  td1.zip et décompressez-la.
Lisez le contenu de wikipedia.py, qui contient un exemple de définition de MDP.
Sous Linux, vous pourrez lancer python plot.py pour visualiser le graphique ainsi produit
(vous pourriez avoir besoin de: apt-get install graphviz).
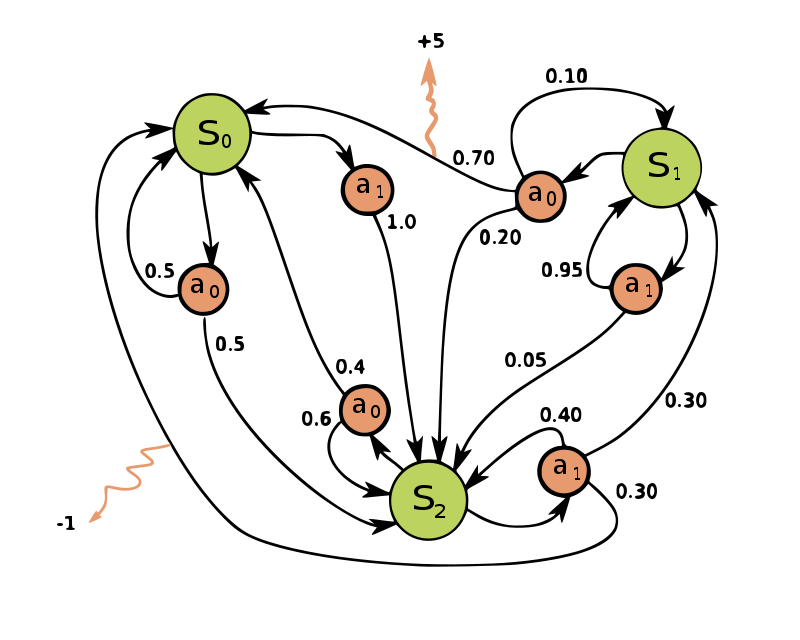
Exemple de Wikipédia
Dans student.py, représentez le MDP de l'étudiant de la même façon.

Exemple de l'étudiant
Nous appellerons implicitement F l'état terminal, qui n'a pas de transitions.
Politique
Nous représenterons des politiques déterministes uniquement comme des dictinonnaires qui associent à chaque état une action :
policy: dict = {
    's1': 'a1',
    's2': 'a2'
}
Fonction de valeur
De la même manière, nous représenterons les fonctions de valeur comme des dictionnaires qui associent à chaque état une valeur :
v: dict = {
    's1': 0.0,
    's2': 0.0
}
Policy evaluation itérative
Dans rl.py, implémentez la fonction suivante :
def compute_value(
    mdp: dict, # Modèle du MDP
    state: str, # État pour lequel on calcule V(s)
    action: str, # Action appliquée par la politique
    gamma: float, # Taux d'escompte
    v: dict # Fonction de valeur
    ) -> float
Qui, pour un état, une action et une fonction de valeur, calcule :
$$V(s) = \sum_{s'} P(s' | s, a) \left[ R(s, a, s') + \gamma V(s') \right]$$Exemple
Dans le MDP de Wikipédia, calculons \(V(s_1)\), sachant que \(\gamma = 0.9\), que \(a = a_0\) et que \(V(s_0) = 1\), \(V(s_1) = 2\) et \(V(s_2) = 3\).
$$\begin{equation} \begin{split} V(s_1) = & \underbrace{0.7}_{P(s_0 | s_1, a_0)} \times (\underbrace{5}_{r(s_1, a_0, s_0)} + \underbrace{0.9}_{\gamma} \times \underbrace{1}_{V(s_0)}) \\ & + 0.1 \times (0 + 0.9 \times 2) \\ & + 0.2 \times (0 + 0.9 \times 3) \\ & = 4.85 \end{split} \end{equation}$$
Dans rl.py, implémentez la fonction policy_evaluation qui calcule la fonction de valeur d'une politique
en utilisant l'algorithme d'évaluation de politique itérative.
def policy_evaluation(
mdp: dict, # Modèle du MDP
policy: dict, # Politique à évaluer
gamma: float = 0.9 # Taux d'escompte
) -> dict Test sur l'environnement de l'étudiant
from student import mdp

v = policy_evaluation(mdp, {
    'I': 'boire',
    'B': 'boire',
    'R': 'boire',
    'BB': 'examen',
    'BR': 'examen',
    'RR': 'examen',
}, gamma=1.0)
Résultat attendu:
{
    'I': 2.0,
    'B': 1.0,
    'R': 11.0,
    'BB': 0,
    'BR': 10.0,
    'RR': 20.0
}
Test sur l'environnement de Wikipédia
from wikipedia import mdp
v = policy_evaluation(mdp, {
    's0': 'a1',
    's1': 'a1',
    's2': 'a1'
}, gamma=0.9)
Résultat attendu:
{
    's0': -0.8532670380050186,
    's1': -0.2879215281600028,
    's2': -0.9491239524008254
}
Policy improvement
Dans rl.py, implémentez la fonction greedy_policy, qui calcule la
politique gourmande
étant donné une fonction de valeur.
def greedy_policy(
    mdp: dict, # Modèle du MDP
    v: dict, # Fonction de valeur
    gamma: float # Taux d'escompte
    ) -> dict
Test sur l'environnement de l'étudiant
from student import mdp
policy = greedy_policy(mdp, {state: 0 for state in mdp}, 1.0)
Résultat attendu:
{
    'I': 'boire',
    'B': 'boire',
    'R': 'boire',
    'BB': 'examen',
    'BR': 'examen',
    'RR': 'examen'
}
Test sur l'environnement de Wikipédia
from wikipedia import mdp
policy = greedy_policy(mdp, {"s0": 0, "s1": 1, "s2": 2}, 0.9)
Réponse attendue:
{
    's0': 'a1',
    's1': 'a0',
    's2': 'a0'
}
Policy iteration
Dans rl.py, implémentez la fonction policy_iteration, qui calcule la politique optimale étant donné un MDP.
def policy_iteration(mdp: dict, gamma: float = 0.9) -> dictPour cela, vous utiliserez les fonctions policy_evaluation et greedy_policy iterativement, en suivant
l'algorithme de policy iteration.
Test sur l'environnement de l'étudiant
Avec \(\gamma = 1.0\), on obtient:
# Politique optimale pi* (MDP étudiant)
{
    'I': 'reviser',
    'B': 'reviser',
    'R': 'reviser',
    'BB': 'examen',
    'BR': 'examen',
    'RR': 'examen'
}
# Fonction de valeur de la politique optimale V*
{
    'I': 20.0,
    'B': 10.0,
    'R': 20.0,
    'BB': 0,
    'BR': 10.0,
    'RR': 20.0
}
Test sur l'environnement de Wikipédia
Avec \(\gamma = 0.9\), on obtient:
# Politique optimale pi* (MDP wikipédia)
{
    's0': 'a1',
    's1': 'a0',
    's2': 'a1'
}
# Fonction de valeur  de la politique optimale V*
{
    's0': 3.784422519192686,
    's1': 7.297775099052718,
    's2': 4.205962364603334
}
Value iteration
Enfin, implémentez la fonction value_iteration, qui calcule la politique optimale étant donné un MDP
à l'aide de l'algorithme de value iteration.
def value_iteration(mdp: dict, gamma: float = 0.9) -> dict Vous testerez votre algorithme sur l'ensemble des MDPs avec les même tests que la section précédente.
Policy evaluation matricielle 🌶️
Nous allons implémenter nos algorithmes dans le fichier rl.py.
Écrivez une fonction compute_transition_matrices qui calcule les matrices \(R\) et \(P\)
telles que:
L'en-tête sera:
def compute_transition_matrices(mdp: dict, policy: dict) -> tuple:Testez là sur l'environement de l'étudiant dans le même cas que vu en cours, et assurez vous d'obtenir le même résultat.
À l'aide de l'exemple du cours, écrivez alors le code de la fonction suivante :
def policy_evaluation_matrix_solve(mdp: dict, policy: dict, gamma: float = 0.9) -> dict:Qui calcule la fonction de valeur d'une politique en utilisant compute_transition_matrices.
Vous testerez votre algorithme sur l'ensemble des MDPs avec les même tests que les sections précédentes.