TD2: Apprentissage sans modèle
 Télécharger l'archive td2.zip
Prise en main
Assurez vous d'avoir installé les dépendances suivantes :
pip install gymnasium[toy-text,classic-control] matplotlibObservez et testez le code suivant, qui charge l'environnement FrozenLake-v1 et le fait jouer aléatoirement pendant 1000 étapes :
import gymnasium as gym
env = gym.make("FrozenLake-v1", render_mode="human")
state, info = env.reset()

for _ in range(1000):
    action = env.action_space.sample()
    state, reward, terminated, truncated, info = env.step(action)

    if terminated or truncated:
        state, info = env.reset()

env.close()
Dans ce TD, nous testerons cet algorithme sur les environnements Toy Text. Vous pourrez utiliser les environnements suivants :
- FrozenLake-v1
- FrozenLake8x8-v1
- Taxi-v3 (attention l'environnement peut être tronqué avant la fin de l'épisode)
- CliffWalking-v0 (attention ne se termine jamais, plus adapté avec Q-learning que Monte Carlo)
- Blackjack-v1 (attention il faut jouer beaucoup de parties pour avoir une évaluation fiable)
Évaluation
Dans un fichier eval.py, et en vous inspirant de l'exemple ci-dessus,
écrivez une fonction eval_policy avec la signature suivante:
def eval_policy(
    env: gym.Env,
    policy: callable,
    n_episodes: int = 1000
    ) -> float
Qui effectue une évaluation de la politique policy passée en argument.
Pour cela, on réalisera 1000 épisodes (et non pas 1000 étapes) et on
calculera le retour moyen par épisode (la somme cumulée des récompenses obtenues).
Vous pourrez la tester avec un code de ce type :
# Évalue une politique aléatoire
eval_policy(env, lambda state: env.action_space.sample(), 10000)
Lorsque vous effectuez une évaluation, il est possible de ne pas réaliser d'affichage
(en enlevant le paramètre render_mode="human") afin d'accélérer l'exécution.
Fonction de valeur état-action
Nous représenterons une fonction de valeur état-action \(Q\) par un dictionnaire Python, qui associera des
tuples (state, action) à leur valeur.
Les fonctions suivantes sont fournies dans q_value.py de l'archive td2.zip:
initialize_q_value: initialise une fonction de valeur état-action pour un environement donné. (Note: on initialise ici \(Q\) à \(1\), et non pas à \(0\), afin d'encourager l'exploration des états inconnus, c'est un mécanisme d'optimisme).load_q_value: charge une fonction de valeur état-action à partir d'un fichier.save_q_value: sauvegarde une fonction de valeur état-action dans un fichier.
Lisez et comprenez le code de ce fichier.
Politique epsilon-greedy
Écrivez le code de la fonction suivante dans q_value.py:
def epsilon_greedy_policy(
    q: dict,
    env: gym.Env,
    state: int,
    epsilon: float = 0.1
    ) -> int
Qui sélectionne une action aléatoire avec une probabilité \(\epsilon\), et qui sélectionne l'action qui maximise la fonction de valeur état-action \(Q(s, a)\) avec une probabilité \(1 - \epsilon\).
Q-Learning
Dans cette partie, nous allons implémenter l'algorithme de Q-Learning.
Apprentissage
Nous allons maintenant écrire un fichier learn.py pour faire notre apprentissage. Nous partirons du code
ci-dessous :
import gymnasium as gym
from gymnasium.wrappers import TimeLimit
from q_value import *

env = TimeLimit(gym.make("FrozenLake-v1"), max_episode_steps=200)
q = initialize_q_value(env)

for episode in range(int(1e6)):
    state, info = env.reset()

    done, truncated = False, False
    while (not done) and (not truncated):
        # TODO: Sélectionner l'action avec epsilon-greedy
        action = ...

        state_before = state
        state, reward, done, truncated, info = env.step(action)
Modifiez le code afin d'utiliser la politique epsilon-greedy sur q pour sélectionner les actions.
Note: L'utilisation de (TimeLimit) permet de limiter (tronquer) les épisodes à
200étapes.
Mise à jour de Q
Dans learn.py,
à chaque étape, mettez à jour la fonction de valeur état-action
en utilisant la mise à jour de Q-Learning.
Attention: dans Q-Learning, on utilise la mise à jour suivante:
$$Q(s, a) \leftarrow Q(s, a) + \alpha \left[ \underbrace{r + \gamma \max_{a'} Q(s', a')}_G - Q(s, a) \right]$$Si \(s'\) est un état terminal, il n'y a pas de récompense futures, et on utilisera à la place l'expression:
$$Q(s, a) \leftarrow Q(s, a) + \alpha \left[ \underbrace{r}_G - Q(s, a) \right]$$Appellez la fonction de sauvegarde de la fonction de valeur état-action à la fin de chaque épisode.
Évaluer
Toujours dans learn.py, utilisez votre fonction d'évaluation pour afficher le retour moyen sur 1000
épisodes toutes les 10000 étapes d'apprentissage.
Vous pourrez pour cela ajouter par exemple un compteur global total_steps
avant la boucle d'apprentissage.
Note: Lorsque vous évaluez, pensez à utiliser une politique gourmande (\(\epsilon = 0\)) pour ne pas avoir d'exploration.
Courbe d'apprentissage
À l'aide de la classe LivePlot fournie dans live_plot.py de l'archive td2.zip,
affichez en temps réel les progrès de votre algorithme d'apprentissage depuis learn.py.
Pour l'axe des absisses, on utilisera le nombre d'étapes totales réalisées depuis le début
(tout épisode confondu, c'est à dire total_steps).
Voici un exemple de courbe pour l'environnement FrozenLake-v1 :
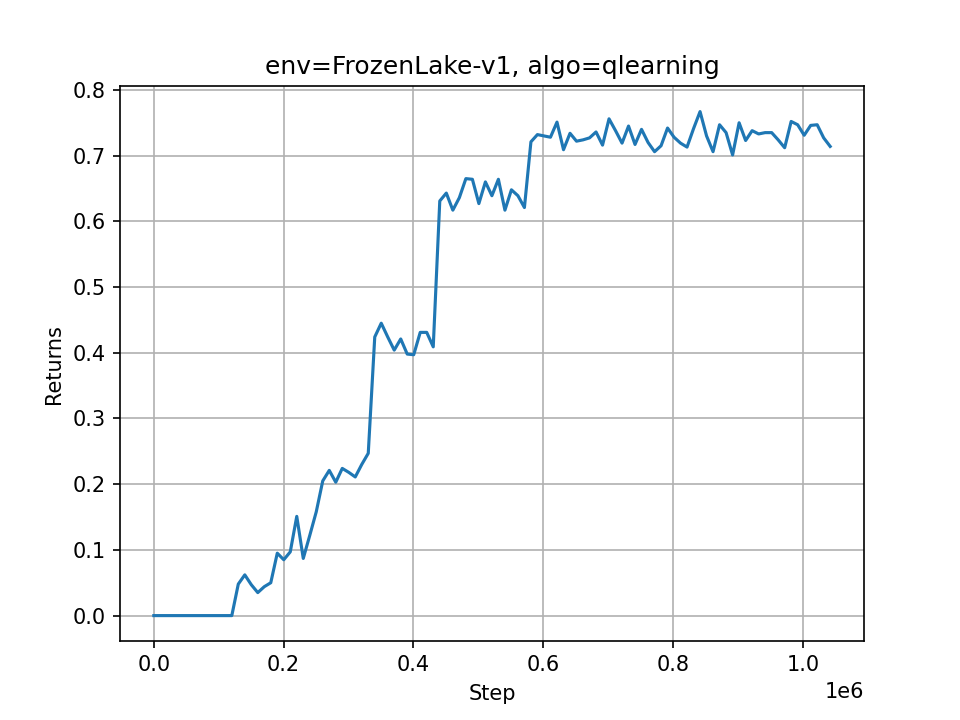
- L'axe \(x\) de la courbe représente le nombre d'étapes totales (et non pas le nombre d'épisodes).
- Dans l'exemple ci-dessus, \(\epsilon = 0.05\), \(\alpha=0.01\) et \(\gamma = 0.95\).
Visualiser
Écrivez un script view.py qui charge la fonction de valeur état-action et qui exécute
la politique epsilon-greedy sur l'environnement appris, en visualisant les étapes
(en utilisant render_mode="human").
Vous pourrez pour cela vous appuyer sur la fonction eval_policy.
Monte-Carlo
Mode Monte-Carlo
Ajoutez une option dans learn.py (par exemple en changeant une variable, ou en utilisant
argparse) pour utiliser
la mise à jour de Monte Carlo à la place de Q-Learning.
Mise à jour de Monte-Carlo
Toujours dans learn.py, à la fin d'un épisode, mettez à jour la valeur de la fonction état-action
\(Q(s, a)\) pour l'ensemble des états et actions rencontrées, en utilisant l'estimation :
L'estimation pour un état donné est la somme des récompenses obtenues à partir de cet état.
Indications
- Vous pourrez stocker les transitions \((s_t, a_t, r_{t+1})\) dans une liste, et la parcourir dans l'ordre inverse à la fin d'un épisode.
- Vous aurez également besoin de stocker le nombre de fois où chaque état-action a été visité, afin de calculer la moyenne des retours à l'aide de la moyenne incrémentale.
Discretisation 🌶️
L'environnement CartPole-v1 est un environnement continu. Il est donc impossible de stocker toutes les valeurs de la fonction de valeur état-action dans un dictionnaire.
À l'aide d'un ObservationWrapper,
discrétisez l'espace d'observation de l'environnement CartPole-v1.
Les bornes fournies par l'environnement sont \((\pm 4.8, \pm \infty, \pm 4.18, \pm \infty)\), nous vous proposons d'utiliser \((\pm 4.8, \pm 2, \pm 0.42, \pm 0.5)\), et d'utiliser 16 pas de discrétisation.
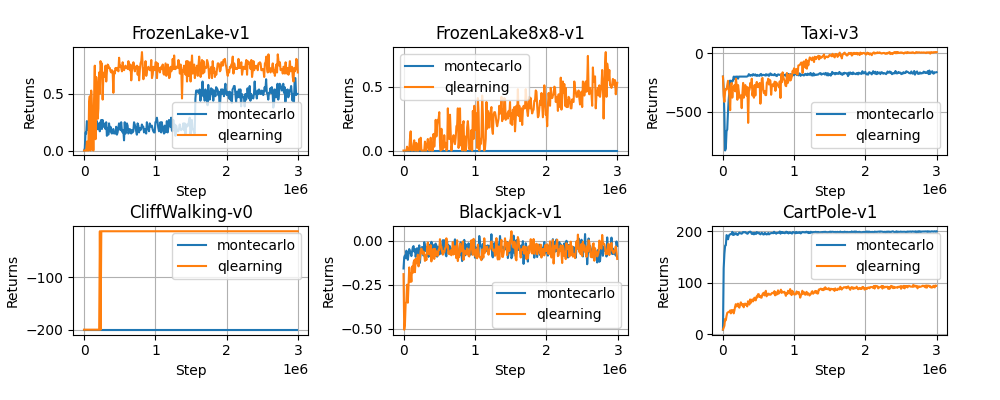
Comparez les résultats de MonteCarlo et Q-Learning.
Courbes d'apprentissage 🌶️
Modifiez le code de manière à pouvoir lancer un benchmark (une évaluation de performance), et comparer les algorithmes. Vous pourriez obtenir des courbes similaires à celles-ci :